Tsurugi(劔)というデータベースの名前、聞いたことがありますか。
ローカルLLM(自分のPCやサーバーで動かす生成AI)や自社データの活用について調べているうちに、この名前に行き当たった方もいるかもしれません。読み方は「つるぎ」。国産のオープンソースデータベースです。
正直に言うと、私も最初にこの名前を見たとき「また新しいDBが出たのか」くらいの感想でした。ただ調べてみると、既存のPostgreSQLやMySQLとは設計思想がかなり違うんですよね。この記事では、Tsurugiが何を解決するために作られたのか、自社に関係があるかどうかを判断できる程度まで、できるだけかみ砕いてお伝えします。
なお本記事の内容は執筆時点(2026年7月)の情報です。OSS(オープンソースソフトウェア)は更新が早いので、実際に検討する際は公式サイトで最新情報を確認してください。
Tsurugi(劔)はどんなデータベースか
Tsurugiは、SQL(データベースを操作するための標準的な言語)で扱えるRDB(リレーショナルデータベース。表形式でデータを管理する仕組み)です。ここは既存のPostgreSQLやMySQLと同じで、使い勝手の面で大きく戸惑うことは少ないはずです。
開発したのはNECと株式会社ノーチラス・テクノロジーズ。国立研究開発法人NEDO(新エネルギー・産業技術総合開発機構)のプロジェクトとして2018年度から開発が進められました。2023年7月にアーリーアクセス版を公開し、同年10月にApache License 2.0というオープンソースライセンスで正式公開しています。
「劔」という漢字の名前や、純国産のRDBがオープンソースで公開されたこと自体が、当時IT業界でそこそこ話題になりました。海外製DBが主流の世界で、国産の高性能DBが無償で使えるようになったのは、素直に珍しい出来事。インフラ寄りの仕事を長くやってきた身としては、こういうニュースはやはり気になります。
何が新しいのか──3つの特徴
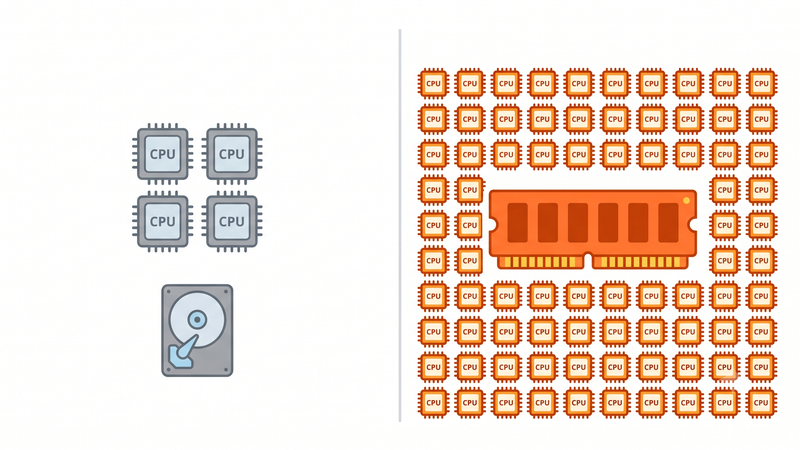
従来主流のRDB(PostgreSQL、MySQL、Oracleなど)は、CPUコア数が少なくメモリも限られていた時代に設計が始まったものが多いです。その土台の上に、後からコアやメモリを増やして性能を伸ばしてきた、という歴史的な経緯があります。
Tsurugiはこの前提をひっくり返しました。最初からメニーコア(多数のCPUコアを持つプロセッサ)と大容量メモリを前提に設計されているのが最大の特徴です。
- メニーコア対応:サーバーのCPUコア数を増やせば、それに比例して処理性能が伸びる設計になっています
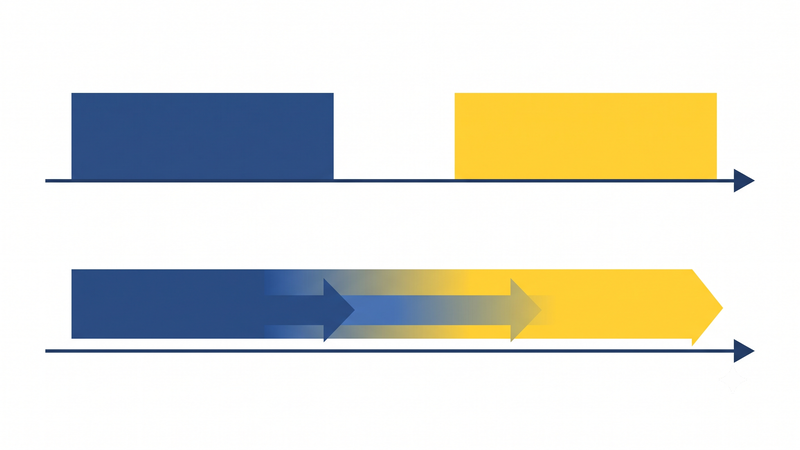
- バッチとオンラインの同時実行:夜間バッチ処理と日中のオンライン処理を、時間を分けずに同時に流せます
- 一貫性を保ったまま高速:整合性(データの矛盾がない状態)を犠牲にしません
2つ目の「バッチとオンラインの同時実行」、これは現場のあるある話です。夜間バッチが想定より長引いて、朝の業務開始までに終わらない。締め処理と日中のオンライン処理がぶつかって、システムを一時止めざるを得ない。こうした経験がある担当者は少なくないと思います。Tsurugiは「時間帯で処理を分ける」という発想自体をなくそう、という設計思想です。
公式発表では、1ノード112コアの検証環境でYCSB-A(データベースの読み書き性能を測る代表的なベンチマーク手法)を使い、約456万TPS(1秒あたりの処理件数)、応答遅延219ナノ秒という数値が示されています。この数字はあくまで特定の検証環境・条件下でのもので、実際の業務システムでそのまま出る値ではありません。ベンチマークの数字を見るときは「どんな条件で測ったか」を必ず確認する癖をつけておくと安心です。
どんな会社・システムに向いているか
公式サイトや事例記事で紹介されている用途を見ると、IoTセンサーからのリアルタイムデータ処理、大量データを扱う分析基盤、応答速度がシビアに求められる基幹システム、シミュレーション用途などが挙がっています。さくらインターネットと組んだ実証実験では、レースカーのテレメトリデータをリアルタイムに処理する用途でも使われました。
ここで正直な話をします。今この記事を読んでいる中小企業の担当者の方の大半にとって、Tsurugiは「今すぐ乗り換える」ものではありません。既存のPostgreSQLやMySQLで業務が問題なく回っているなら、無理に移行する理由はないでしょう。
ただし、将来的に自社サービスで大量データを扱う構想があったり、IoTデータをリアルタイムで捌く必要が出てきたりしたときには、選択肢の一つとして知っておいて損はありません。私自身、ローカルLLMの導入相談を受ける中で「将来的にデータ基盤も見直したい」という声を聞く機会が増えてきた、というのが正直な実感。そのときの引き出しの一つとして頭の片隅に置いておく、くらいの温度感がちょうどいいと思います。
導入のハードルと注意点
現時点でTsurugiが正式にサポートしているOSは、主にUbuntuです。AlmaLinuxとRocky Linuxにも対応が進んでいますが、こちらはバージョン9系での試験的機能という位置づけ。Windows上で気軽に、という状態にはまだ達していません。
新しいOSSということもあり、日本語での実践的な情報はまだ多くないのが実情です。トラブルシューティングの情報を探すと、公式ドキュメントや開発元の記事に頼らざるを得ない場面が多いというのが正直なところ。一方で開発元のノーチラス・テクノロジーズが商用サポートを提供しており、さくらインターネットとの連携も進んでいます。企業として本格導入する際の受け皿は、少しずつ整いつつある段階です。
とはいえ悪い話ばかりではありません。あらかじめTsurugiがインストールされたDockerイメージ(アプリケーションを環境ごとパッケージ化する仕組み)が公式で用意されていて、動作確認だけなら意外と手軽に始められます。「触ってみたいけど本番導入はまだ早い」という段階の検証には、ちょうどいい入り口だと思います。
まとめ
Tsurugi(劔)についてお伝えしてきた内容を整理します。
- メニーコア・大容量メモリという今のハードウェアに合わせて設計された国産RDB
- 夜間バッチと日中オンライン処理を同時に流せる点が最大の特徴
- 中小企業がすぐ乗り換える必要はないが、大量データや高速処理を将来的に検討するなら選択肢の一つ
- 現状はUbuntu中心で日本語情報はまだ少なめ。ただしDockerで気軽に試せる
新しい技術を知っているかどうかは、いざというときの提案の幅に直結します。Tsurugiのようなツールも、まずは名前と特徴を頭に入れておくだけで十分です。
私はこうした新しい技術のPoC(実証実験)支援や、自社のデータ基盤についての相談も受け付けています。「うちのシステムにも関係あるのかな」と気になった方は、一度相談してみるのも一つの手だと思います。
次回は、DockerとUbuntuを使った実際のインストール手順を解説します。手を動かして触ってみたい方はぜひ読んでみてください。
▼シリーズ一覧
– 第1回:Tsurugi(劔)とは?国産次世代データベース入門(本記事)
– 第2回:Tsurugi(劔)を試す!インストール〜起動手順(インストール編)
– 第3回:PythonでTsurugi(劔)に接続してみる(Python接続編)
– 第4回:Tsurugi(劔)のセキュリティ設定入門:認証を有効にする(セキュリティ編)
コメント